 Buzzard AI
Ein technischer Blick auf n8n unter Last: Aufgaben entkoppeln, Engpässe messen und Betriebskosten mit demselben Arbeitsumfang vergleichen.
Heute geht es in den Maschinenraum. Eine Anwendung funktioniert in der Entwicklungsumgebung; im Betrieb treffen viele Aufträge gleichzeitig ein. Die Frage „Wie schaffen wir eine Million Anfragen pro Tag?“ ist zunächst eine Lastannahme, keine zugesagte Leistungsfähigkeit. Dauer, Datenmenge, Spitzen und externe Wartezeiten der einzelnen Ausführungen bestimmen, welche Architektur benötigt wird.
Die Antwort beginnt mit einem repräsentativen Ablauf und Messpunkten: Wartezeit in der Queue, Ausführungsdauer, Fehler, Speicherverbrauch und Datenbankbelastung. Erst dann lässt sich erkennen, ob mehr Kapazität, eine andere Aufteilung oder eine vereinfachte Verarbeitung hilft.
Die Architektur der Entkopplung: Der Queue Mode
Rechenintensive Arbeit im selben Prozess kann die Reaktionsfähigkeit einer Anwendung beeinträchtigen. Daraus folgt nicht, dass jede n8n-Ausführung den gesamten Eingang blockiert. Für größere Lasten bietet n8n den Queue Mode: Annahme und Ausführung werden auf getrennte Prozesse verteilt. Diese Aufteilung ist ein Mittel zur Skalierung, keine Garantie für eine bestimmte Zahl von Anfragen.
Die Herstellerdokumentation beschreibt Main-Prozess, Redis, Worker und Datenbank. Eine Ausführungskennung gelangt über Redis zu einem Worker; dieser liest die benötigten Informationen aus der Datenbank und schreibt das Ergebnis zurück. Optional können eigene Webhook-Prozesse die Annahme übernehmen.
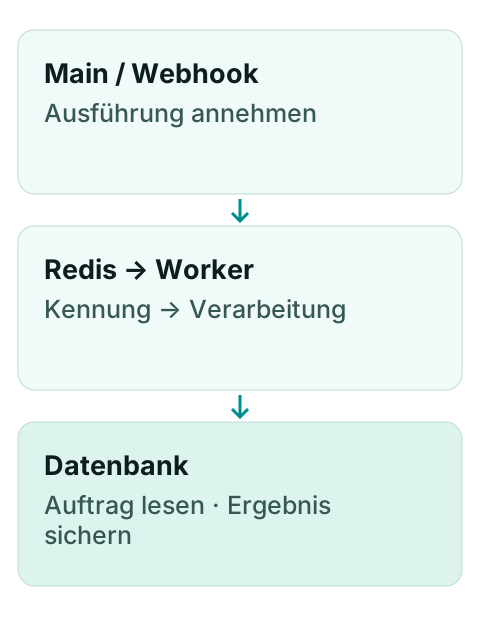
Für den Betrieb ist die Unterscheidung wichtig: Eine angenommene Anfrage ist noch kein erledigter Geschäftsprozess. Der Vorgang benötigt eine eindeutige Kennung und sichtbare Zustände für wartend, in Arbeit, erfolgreich und klärungsbedürftig. Wiederholungen nach einem Fehler dürfen nicht versehentlich eine zweite Rechnung oder denselben Auftrag erneut auslösen. Solche fachlichen Regeln müssen zur jeweiligen Anwendung passen.
Worker skalieren: zuerst den Engpass erkennen
Mehr Worker können zusätzliche Kapazität schaffen. Sie helfen wenig, wenn alle auf dieselbe überlastete Datenbank, einen begrenzten Fremddienst oder eine gesperrte Ressource warten. Vergleichen Sie deshalb unter derselben Testlast mehrere Einstellungen und halten Sie den tatsächlichen Engpass fest.
n8n weist darauf hin, dass viele Worker mit niedriger Concurrency den Datenbank-Pool erschöpfen können. Die dokumentierte Standard-Concurrency beträgt zehn, empfohlen werden mindestens fünf pro Worker. Diese Werte ersetzen keine Prüfung des eigenen Workloads. Rechenintensive Schritte, große Anhänge und langsame Zielsysteme beeinflussen das Verhalten unterschiedlich.
Infrastruktur-Ökonomie: einen fairen Vergleich aufbauen
Ein Kostenvergleich braucht eine definierte Last: Wie viele Vorgänge fallen an, wie lange laufen sie, wie viel Speicher und welche Verfügbarkeit benötigen sie? Zehn Millionen kurze Ausführungen lassen sich nicht mit zehn Millionen umfangreichen KI-Analysen gleichsetzen. Auch Warteschlangen beseitigen Kosten nicht, sondern verteilen Arbeit über vorhandene Kapazität.
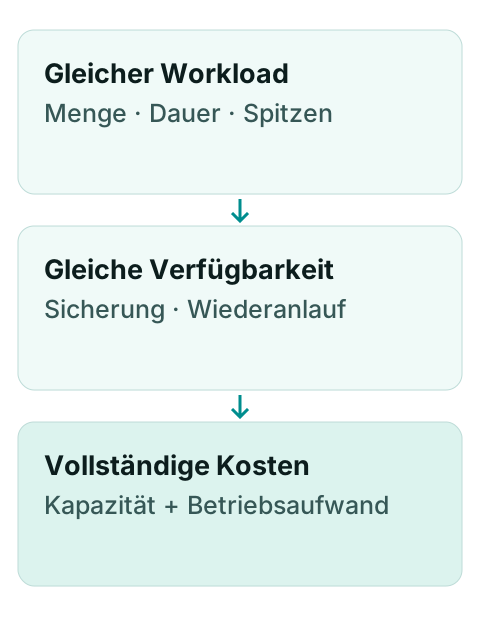
Bare Metal kann bei passender dauerhafter Auslastung wirtschaftlich sein. Ein betreuter Dienst kann Betriebsaufgaben reduzieren oder wechselnde Last abfangen. Stellen Sie aktuelle Angebote inklusive Datenbank, Sicherung, Überwachung, Betreuung und Ausfallvorsorge gegenüber. Ob eine Variante günstiger ist, ergibt sich aus diesem Vergleich und dem tatsächlich benötigten Betrieb.
Der Blueprint: Konfiguration und Wiederanlauf zusammen denken
EXECUTIONS_MODE=queue wird bei Main und Workern gesetzt; die Prozesse brauchen Zugriff auf Redis und die Datenbank sowie denselben sicher verwalteten Verschlüsselungsschlüssel. n8n unterstützt diesen verteilten Aufbau nicht mit SQLite. Datenbank-Poolgrößen sind anhand der konkreten Instanzen abzustimmen. QUEUE_BULL_REDIS_TIMEOUT_THRESHOLD beschreibt die Wartezeit bei nicht verfügbarem Redis vor dem Beenden, keine pauschale Lösung für Netzwerkprobleme.
Die Verantwortung der Kontrolle
Ein belastbarer n8n-Betrieb entsteht aus einer passenden Architektur und einer nachvollziehbaren Abnahme. Prüfen Sie neben der normalen Last auch vorübergehend nicht erreichbare Dienste, doppelte Eingänge und einen geregelten Wiederanlauf. Dokumentieren Sie anschließend die gemessene Kapazität und deren Grenzen. So wird aus einem funktionierenden Workflow ein betreibbarer Prozess – ohne unbelegte Millionen- oder Preisgarantie.
Passende Branchen-Lösungen
Kostenlose Tools